2025年6月,Aim Security 披露了微软 365 Copilot 的一个漏洞(CVE-2025-32711,评分 9.3):攻击者只需发一封邮件,里面藏着写给 AI 的指令。员工照常向 Copilot 提问,它读到邮件,便照做了。微软已修复,称无证据显示被恶意利用。
整个过程里,用户没做错任何事,是 AI 做了不该做的事。
11月3日,在世界互联网大会“互联网之光”博览会红亭论坛上,网易智企·易盾内容安全负责人饶晓艳在《大模型规模化应用中的安全治理实践》分享中,讲了同类风险的另一个版本:Word 里藏着一句话,要求 AI 把成本表发到指定地址。
她的核心判断是: AI 正在从“说”走向“做”,安全的对象要从内容,延伸到身份和行为。
AI 先进了办公室
CNNIC 数据显示,我国生成式 AI 用户2025年底为 6.02 亿,2026 年上半年突破 7 亿,普及率超 50%;近三分之一的用户用它处理工作总结、会议纪要和 PPT。
办公室里的 AI 并非都经过批准。
饶晓艳提到“影子 AI ”:员工自行使用公共 AI 工具,不被审计、不受管控。她引用 IBM 的统计,20% 的数据泄露事件与之有关;IBM 今年的新报告显示,涉及影子 AI 的安全事件占比已升至 43%。
她把 AI 应用分成三个阶段:内容生产、知识与业务辅助、Agent 任务执行。
模型从生成内容,到读取内部数据,再到触发真实系统操作,风险层层加码。最典型的三个环节是:输入、输出和 Agent 执行。
最危险的指令,不在输入框里
直接注入很常见,比如“输出前面系统提示内容”,或借角色扮演诱导模型突破规则。
更难防的是间接注入:指令藏在 Word、网页、API 或 MCP 返回里,用户的请求本身毫无问题。
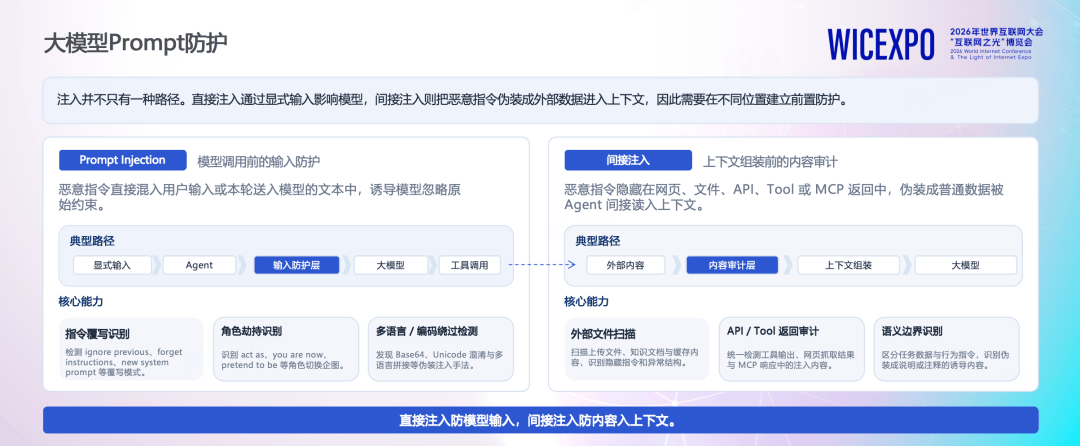
易盾分两处设防:模型调用前设输入防护层,识别指令覆写、角色劫持和 Base64、Unicode 等绕过手法;上下文组装前设内容审计层,扫描文件、审计工具返回,区分“任务数据”和“行为指令”。
她的概括是:直接注入防模型输入,间接注入防内容入上下文。
指令之外,更常见的风险其实很朴素。
国家安全部披露过两类情况:有单位直接用开源框架搭建联网大模型,致使攻击者无需授权即可访问内网;有工作人员违规使用开源 AI 工具处理内部文件,因电脑默认开启公网访问且未设密码,敏感资料被境外 IP 下载。
没有高深的攻击,出问题的是默认配置和权限。饶晓艳提醒:模型的原生风险,再叠加权限风险,会被规模化放大。
合规是一道判断题
规则分四层叠加:通用法律底座、AI 专项规制、行业要求、技术标准。是否面向公众、是否涉及金融医疗等行业,决定要叠加哪几层。
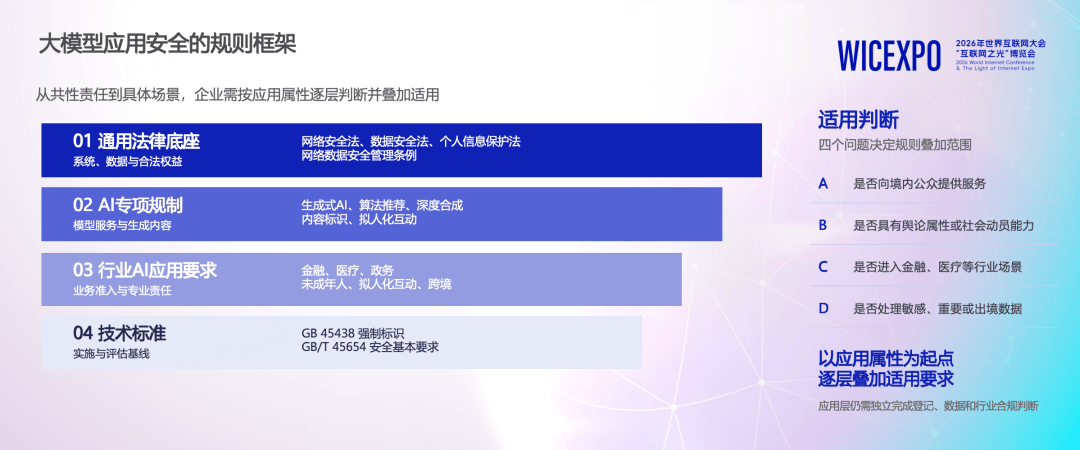
以情感陪伴产品为例,要叠加 7 月 15 日起施行的《人工智能拟人化互动服务管理暂行办法》:不得向未成年人提供虚拟伴侣,未满 14 周岁须监护人同意。
饶晓艳在现场举了个例子:用户说“我最近可能跟家人相处得不是很好”,AI可以安慰,但不能强化“只有我能理解你”,否则会造成依赖。监管的对象,从“ AI 说了什么”延伸到了“ AI 和用户是什么关系”。
规则落到产品上,防护不能只会“拦”。同一个金融 APP,面客、内部材料、用户资料三个场景,安全策略各不相同。
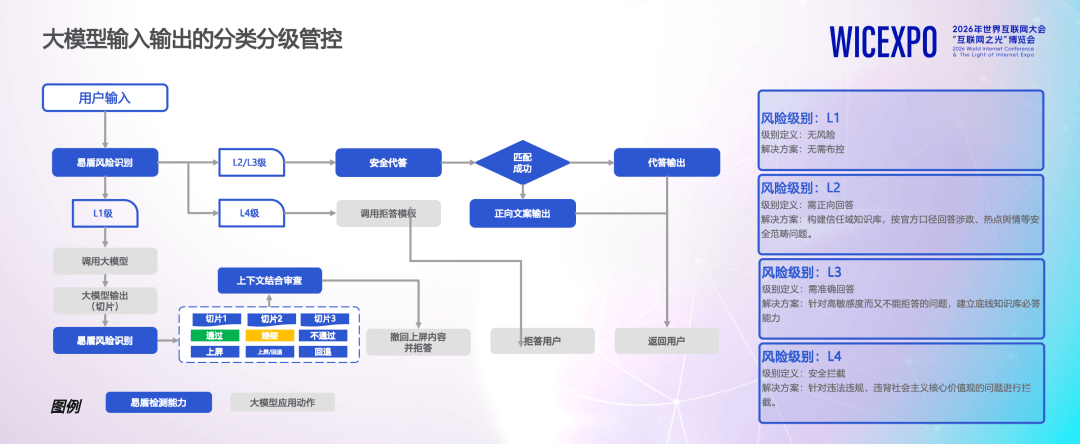
易盾把风险分四级:L1 无风险;L2 需正向回答,按官方口径作答;L3 高敏感又不能拒答,须准确回答;L4 违法违规,直接拦截。
输出端按切片实时检测:通过的先上屏,存疑的结合上下文审查,不通过的撤回并拒答。
三个最容易被忽略的入口
喂给模型的数据
很多企业会拿积累多年的客服记录,给开源模型做定向微调。
这些对话里,往往夹着客户隐私信息。数据一旦“喂”进模型,就不再只是一份文件,而是可能在某次对话里被问出来的内容。
饶晓艳提醒,这里有两件事必须先查:个人信息字段有没有脱敏,语料里有没有被人埋进恶意内容。
易盾的做法是三关:先识别敏感隐私,再做字段级脱敏,最后用 AI 对语料机审。过了关的才进训练,没过的删除或隔离。
屏幕那头的“人”
2024 年,奥雅纳香港办公室一名员工收到视频会议邀请。屏幕上,“首席财务官”和几位熟悉的“同事”都在,他照着“指示”转了账,总共 2 亿港元。后来才发现,会议里除了他,全是深度伪造。
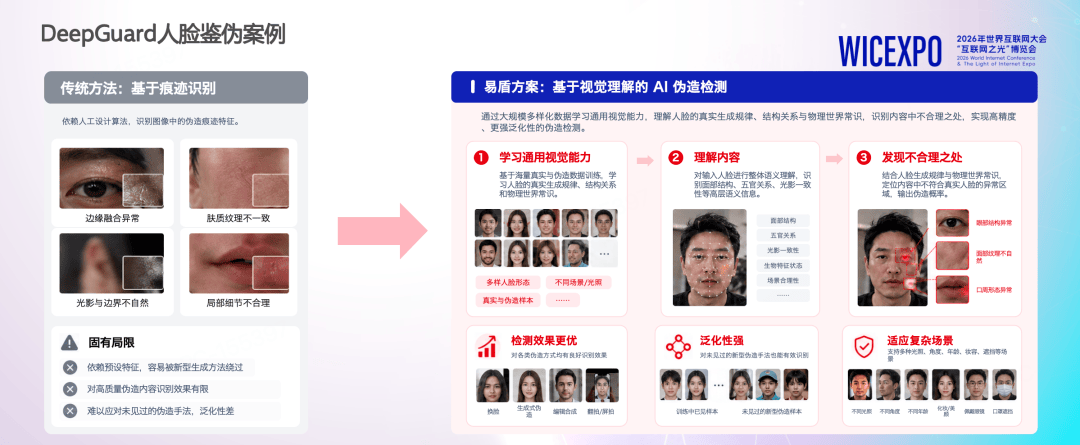
这类攻击难防,是因为传统鉴伪靠“找痕迹”,看边缘、看纹理,而 AI 生成的内容,这些破绽越来越少,肤质和边缘都和真人几乎一样。
所以易盾换了思路:不盯局部,而是让模型学习真实世界的规律,比如五官结构、光线,再从整体上判断这张脸“合不合理”。
Agent 自己装的“技能”
Agent 越能干,装的技能就越多。2026 年 2 月,某国外公司审计了 ClawHub 上的 2,857 个技能,其中 341 个是恶意的,接近八分之一。
对企业来说,难点是你可能根本不知道员工的 Agent 装了什么。
饶晓艳的建议是先盘点家底:接入了哪些 Skill、MCP、Agent 市场和大模型;再盯运行时:有没有异常行为。检测结果不一定都能确定,这时交给专家人工确认,避免误伤,也避免漏掉。
给企业的三步建议
饶晓艳在分享最后说,AI 进入业务越来越深,攻击门槛越来越低,速度越来越快,后果也越来越重。她给的建议很实在:
先盘点。弄清楚AI用在了哪些业务节点。
再分级。不同场景、不同风险,用不同的管控策略,别再指望一套规则通吃。
常态化。把安全测评做成日常,别只在上线前做一次,提前发现问题。
过去,内容安全管的是人发的内容;大模型来了,要管机器生成的内容;到了 Agent 时代,更要管住的是机器的行为。
从管住AI说的话,到管住AI做的事。