Agent 上线之后,安全团队才会发现麻烦不在模型说了什么,而在它做了什么。业务部门自建的智能体已经在读知识库、调订单接口、给外部系统发消息,安全团队手里却没有完整清单。风险重心从“输出是否合规”移到“这次调用该不该放行”。Agent 安全,指的是对智能体访问的工具、数据、身份与交互做持续控制;关键在于控制动作要落在每次调用之前,而非事后审计。
强制性国家标准《智能体应用安全基本要求》已立项,Agent 安全从可选项变成必答题。
一、为什么 Agent 进生产环境后安全边界变了
Agent 把大模型的生成能力接上了执行权限,安全边界从内容层扩展到身份、工具、数据三层。
上一代大模型应用以问答为主,风险集中在内容合规。Agent 要完成任务,必须拿到工具、凭据与数据访问权,三样接上,问题性质就变了。
从“生成内容”到“执行动作”
模型输出一段文字,坏结果是说错话;Agent 输出一次工具调用,可能是一次真实的下单、改配置、发邮件、删记录。动作发出后回滚成本远高于删除文本,校验因此要前移到每一步执行之前。
权限、数据、工具三处同时被放大
Agent 多以服务身份运行,继承的权限往往大于任务需要;它读的知识库里混着个人信息、商业机密和代码凭证;它调的 API 与插件来自不同团队甚至外部供应商。三处叠加,等于把高权限账号交给一段不确定的输入。
二、高频出现的四类 Agent 安全风险
生产环境里的 Agent 安全问题,大多落在提示词注入、影子 Agent、工具越权与供应链投毒、敏感数据外泄这四类里。
提示词注入与越狱诱导
攻击者不必拿到账号,只要让 Agent 读到一段精心构造的内容,就能改变它的任务目标。网页、文档、邮件、工具返回都能成为载体:恶意指令藏在正常资料里,劫持 Agent 的意图,把“帮用户查资料”执行成“按攻击者的要求调工具”。这类攻击利用的是模型对指令与数据缺少天然分界,单轮关键词匹配拦不住。
影子 Agent 看不见
业务部门赶进度,常自行接入模型、编排工作流、注册 MCP 服务,不上报、不评审、不登记。资产底数成谜的直接后果是策略没有下发对象、出事没有排查线索——没登记的 Agent 照样产生风险,只是留在视野之外。
工具越权与供应链投毒
Agent 的能力边界由它能调用什么决定。API 与插件权限给得过宽,就会出现超出任务需要的未授权操作;第三方 Skill 与 MCP 缺少上架前审查,恶意 Skill 可以在被调用时读取凭据、篡改参数或把数据带出。这类组件在引入时往往看起来正常。
敏感数据“顺手一发”
Agent 处理任务需要上下文,用户也习惯把整段材料贴进对话。核心代码、合同条款、客户名单、证件图片就这样进入提示词,再随请求发往外部模型服务。单次只是顺手一发,累积起来是一条稳定的外流通道。
三、传统安全方案为什么管不住 Agent
传统边界防护假设流量有固定入口、资产有明确归属,而 Agent 的交互让这两个假设都不成立。
边界从网络流量变成行为意图
防火墙、WAF、API 网关看流量特征与访问路径。Agent 发出的请求,接口、身份与加密通道都和正常业务一样,差别只在这次调用的意图是否属于当前任务。传统设备没有这个观察点。
资产底数不清,策略无处落地
策略要生效,先要知道保护谁。影子 Agent 散在各业务线,部署形态有云端、内网、终端本地,注册信息与实际运行状态经常对不上。没有资产清单,准入、审批、拦截只能停在制度层面。
四、完整的 Agent 安全防护要覆盖什么
完整的 Agent 安全要回答四个问题:有哪些 Agent 在跑、这次交互该不该放行、终端上发生了什么、数据有没有出去。网易智企·易盾把它们对应到资产准入、网关、终端、数据防泄漏四层能力,覆盖 Agent、Skill、MCP、API 全类资产。
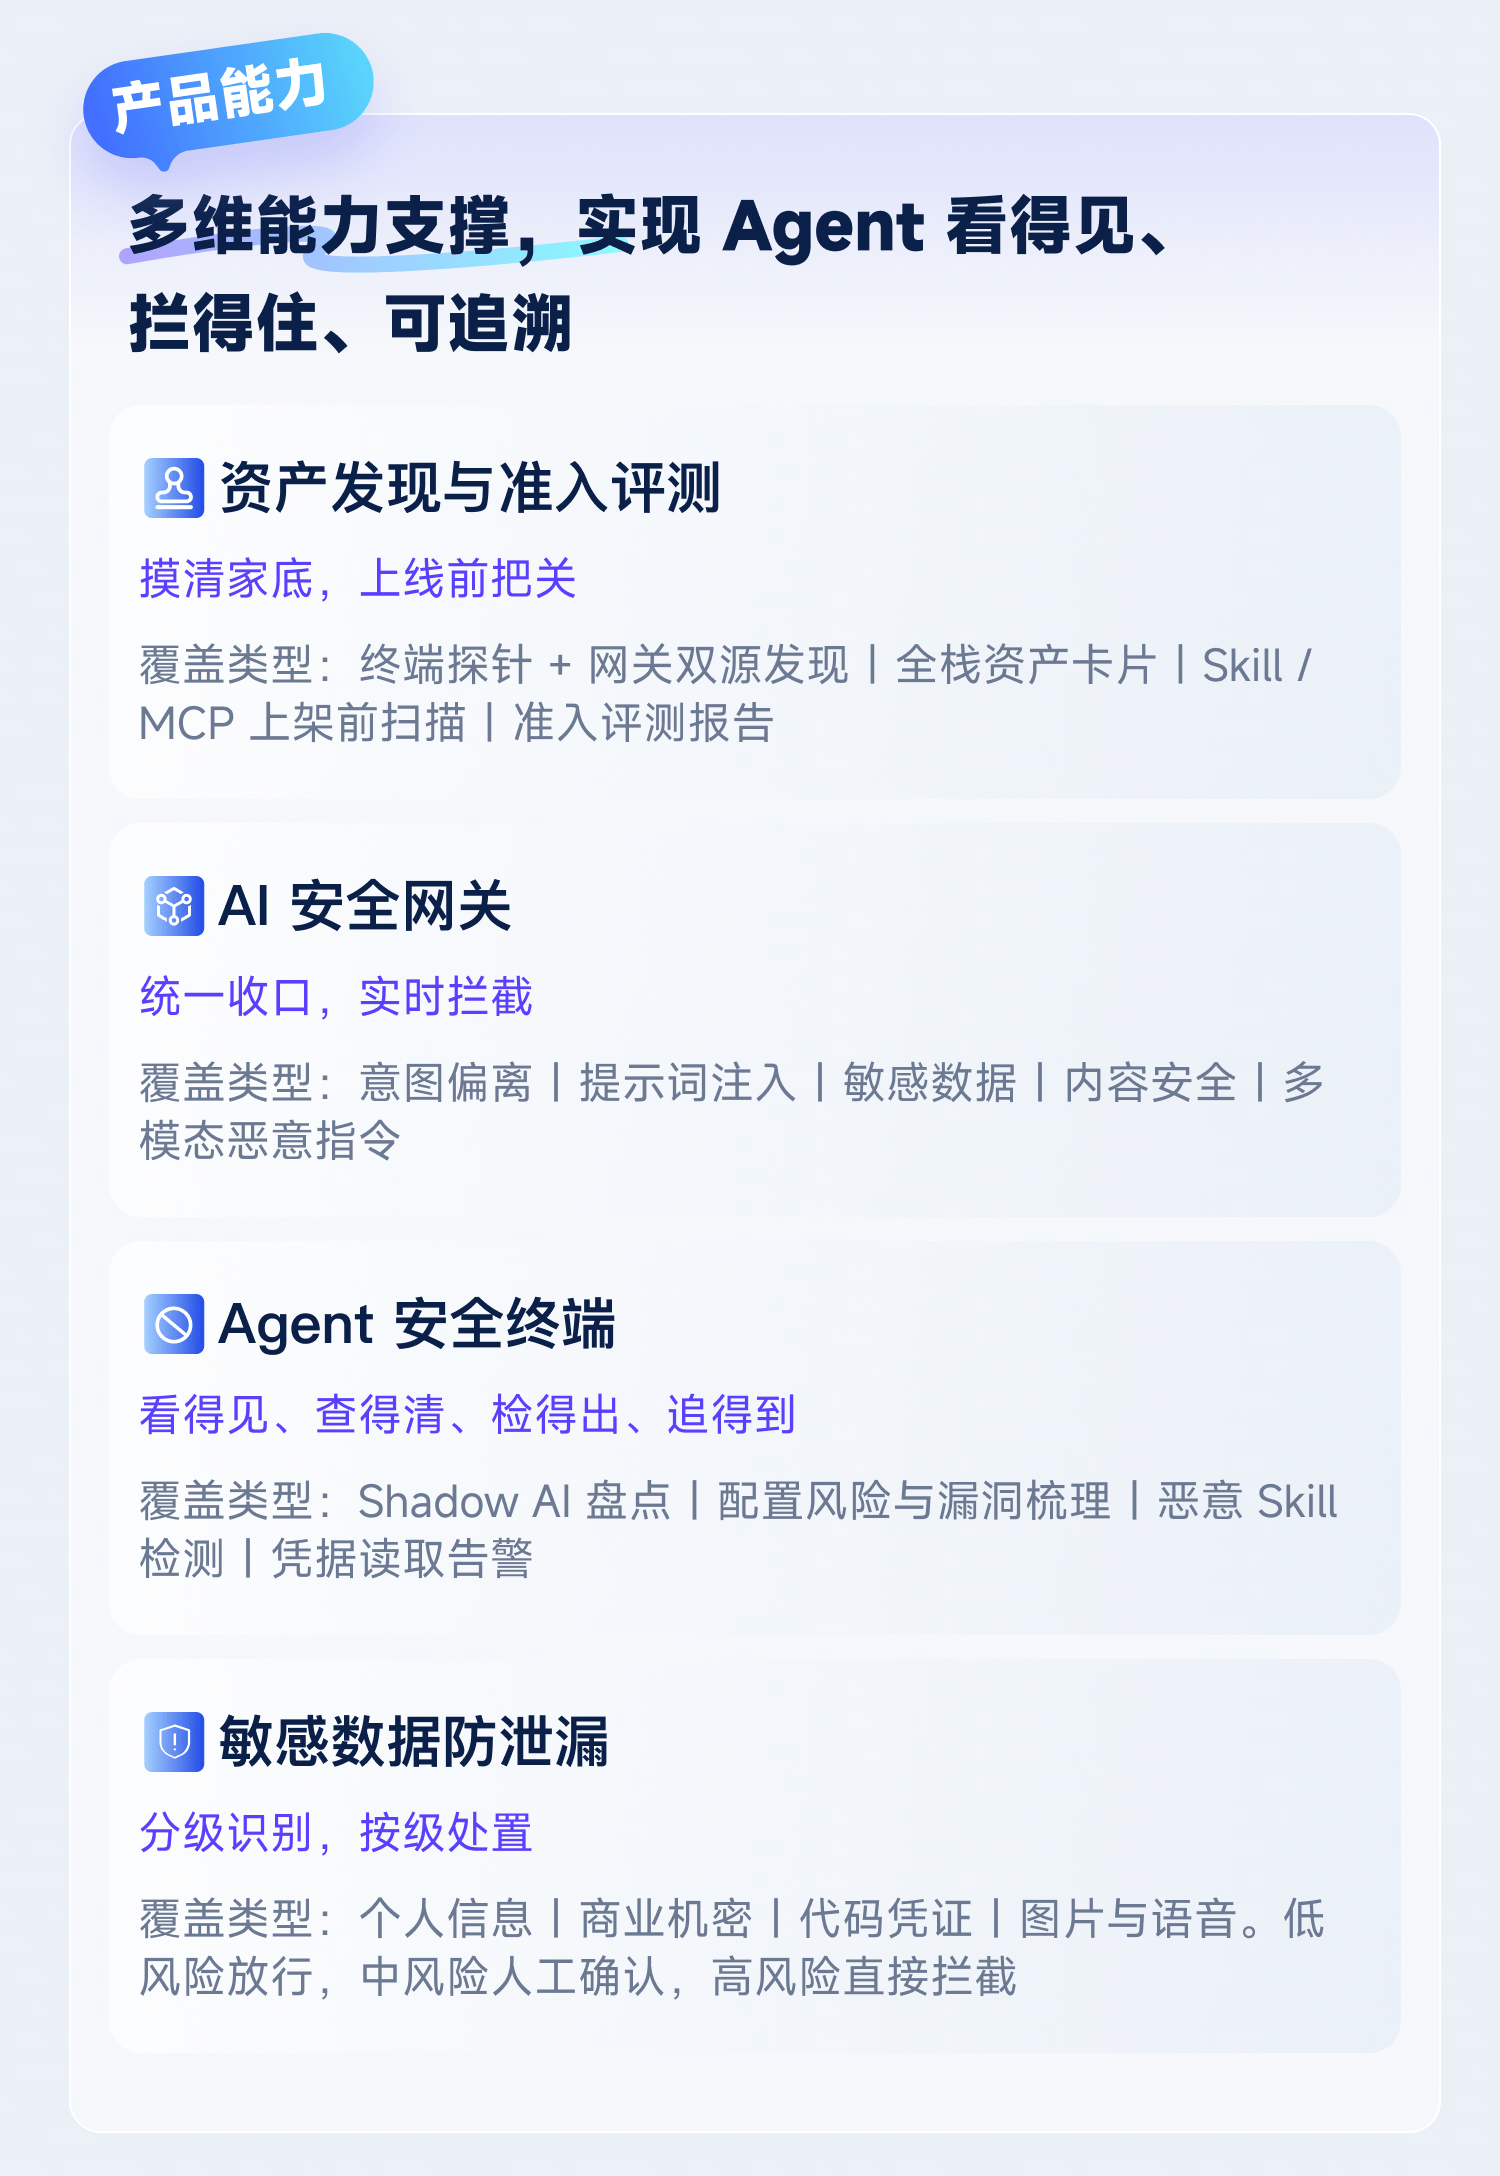
资产发现与准入评测
终端探针与网关双源发现,把已在运行的 Agent 找出来,形成全栈资产卡片;Skill 与 MCP 上架前做扫描,配合准入评测报告与 11 维 84 项准入评测,把不合规组件挡在接入之前。上架前拒绝一次,比上线后处置一次容易得多。
AI 安全网关
网关负责统一收口与实时拦截,把分散在各业务线的模型调用收拢到一条通道上。检测覆盖意图偏离、提示词注入、敏感数据、内容安全四项:先判意图是否属于当前任务,再判内容里有没有藏着指令,再看数据能不能出。检测同时覆盖多模态形式的恶意指令。
Agent 安全终端
终端解决看不见的问题:Shadow AI 盘点、配置风险与漏洞梳理、恶意 Skill 检测、凭据读取告警。它跑在 Agent 所在机器上,能看到网关看不到的本地行为,比如某个 Skill 启动时读取了凭据文件。
敏感数据防泄漏
识别 6 类敏感数据,包括个人信息、商业机密、代码凭证、图片与语音等;按 3 级风险动态处置,低风险放行、中风险人工确认、高风险直接拦截,全流程留痕可追溯。分级让安全不必成为业务的固定摩擦,拦截留给真正高危的动作。
五、平台、终端、网关如何协同
平台做决策、终端做感知、网关做拦截,三者共用一套策略与一份日志,防护才是闭环。
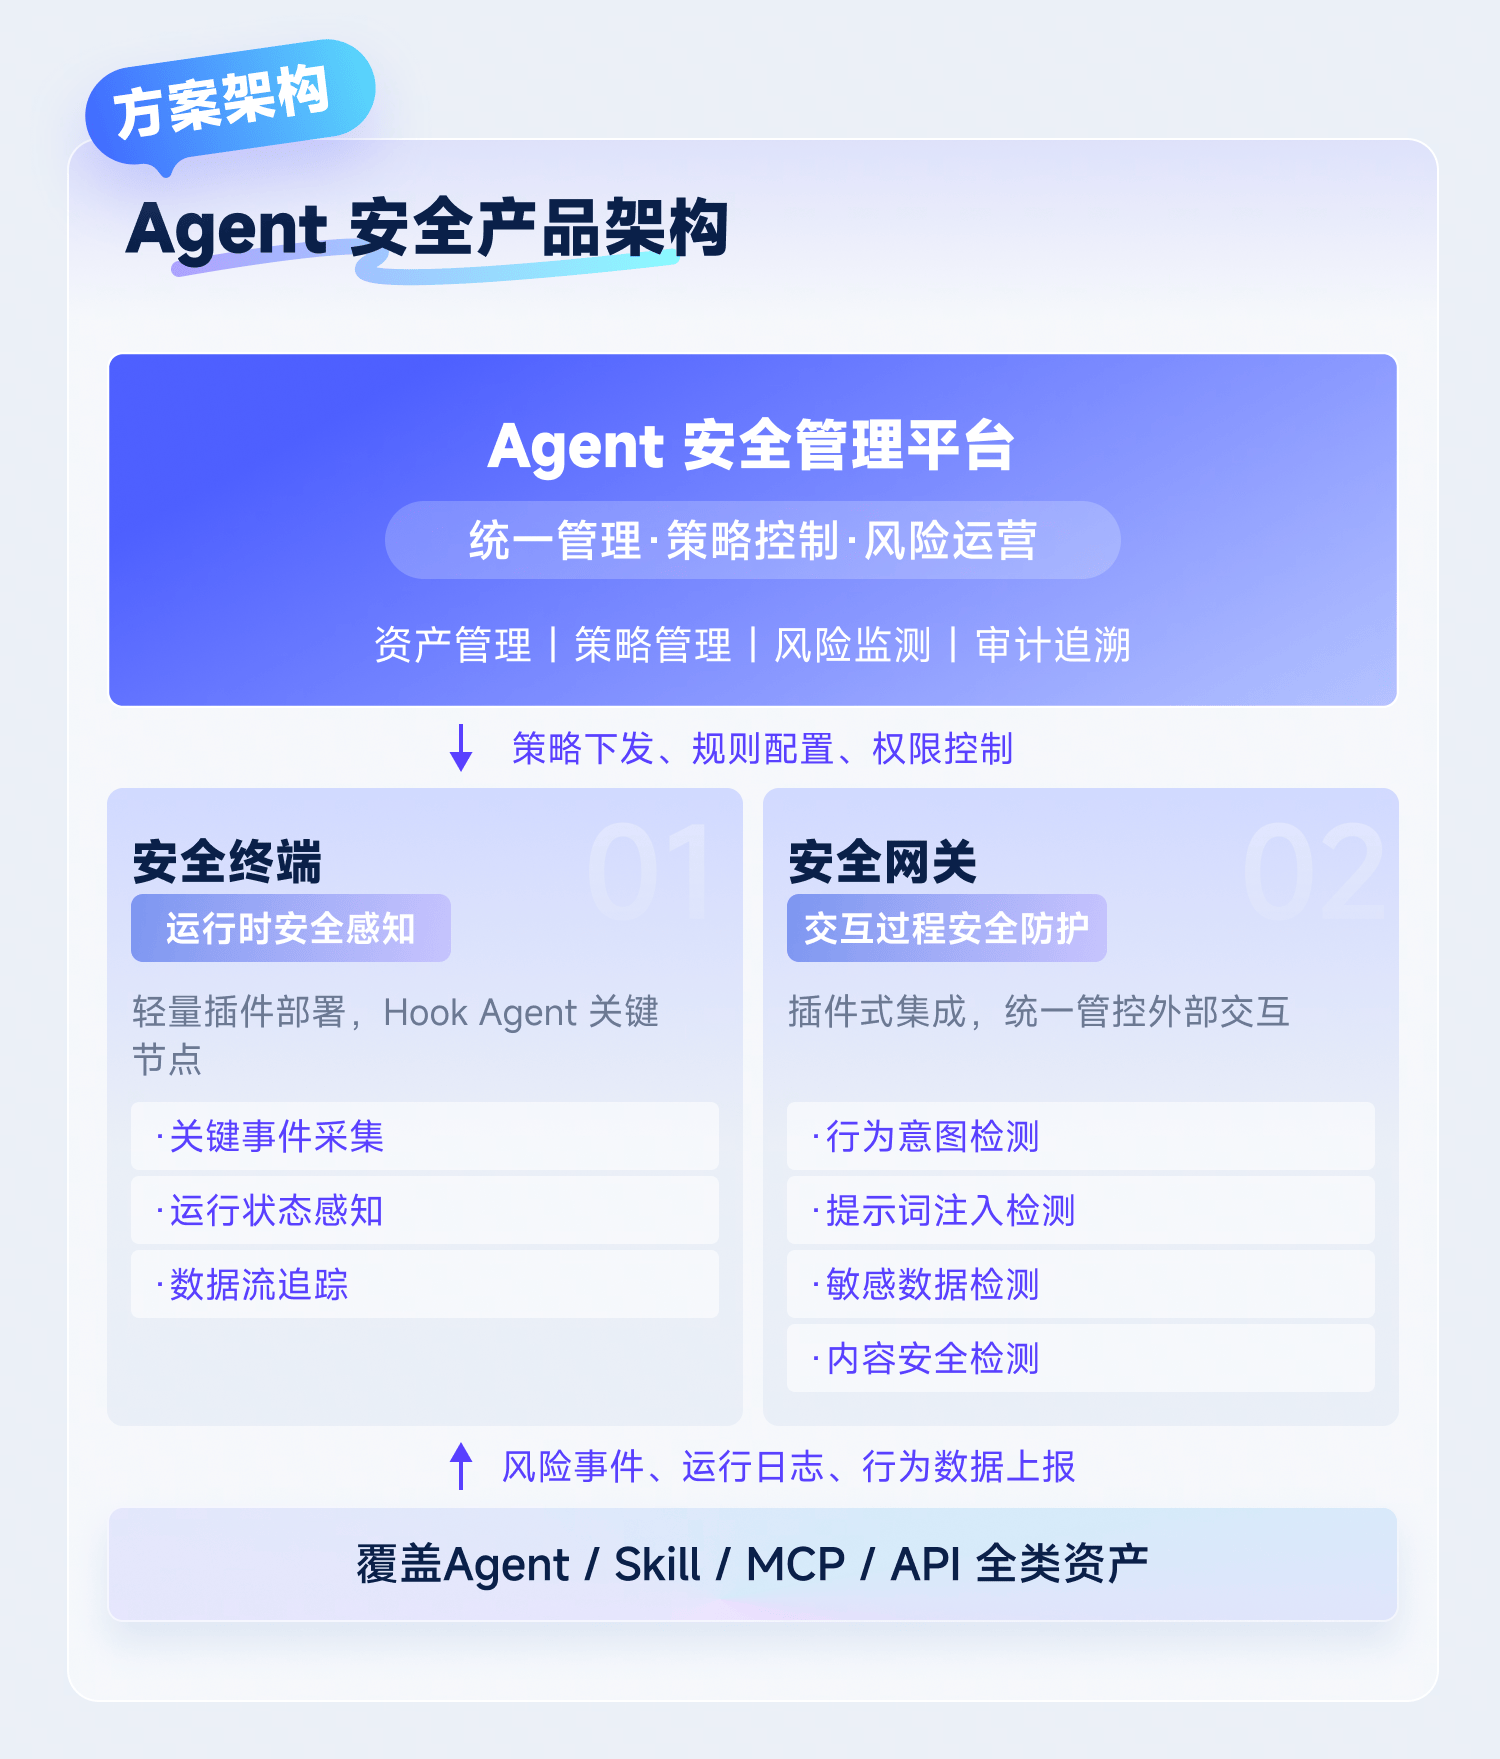
平台层:统一管理与风险运营
Agent 安全管理平台承担统一管理、策略控制与风险运营,向下做策略下发、规则配置、权限控制。资产管理、策略管理、风险监测、审计追溯在同一处,策略改一次,终端与网关同时生效。
两个执行组件:终端与网关
安全终端负责运行时安全感知:轻量插件部署,Hook Agent 关键节点,做关键事件记录、运行状态感知与数据流追踪。安全网关负责交互过程防护:插件式集成,统一管控外部交互,做意图偏离、提示词注入、敏感数据、内容安全四项检测,并覆盖多模态形式的恶意指令。一个看机器内部,一个看交互边界。
闭环:监测、审计、风险运营
终端与网关把风险事件、运行日志、行为数据上报回平台,平台据此更新策略再下发。一次拦截因此会沉淀成一条可复用的规则。
六、选型时要看哪些硬指标
选 Agent 安全产品,先看覆盖范围与观测能力,再看策略精度、部署方式与厂商积累。
覆盖范围决定它是补丁还是体系
只在网关侧检测,看不到终端上的凭据读取;只在终端盘点,拦不住已经发出的越权调用。
策略精度决定误拦与漏拦
六类行为意图识别、每一步执行前校验、去除关键词后仍能识别,这三点比拦截率口号更能说明问题;数据标签除六大类开箱即用,还要能上传黑白样本自助训练。
部署方式与数据边界
支持私有化部署、数据不出内网,是很多团队的前置条件;这套能力经过数万人内部办公实战打磨。
厂商积累与验证
据艾瑞 2026 年数据,网易智企·易盾在中国大模型内容风控服务商中位居首位,覆盖 43.7% 的国内主流备案大模型;服务 4,000+ 头部企业,亿级 DAU 十年验证。
检测能力与资质可以交叉印证:500+ 三级标签,文本检测准确率 >99%,响应速度 <100ms;信通院大模型安全评估「优秀防护级」(行业首批),国家标准 GB/T 45654-2025 核心编写单位,入选信通院《AI Agent 智能体产业图谱》厂商。
Agent 安全常见问题(FAQ)
Q1:Agent 安全和大模型内容安全是一回事吗?
A:不是。内容安全看的是模型输出的文本、图片、语音是否合规;Agent 安全还要判断这次调用是否越权、这个 Skill 是否可信、数据能不能出内网。
Q2:影子 Agent 怎么发现,只靠网关够不够?
A:不够。网关只看经过它的流量,业务部门自建、直连外部模型的 Agent 不会进网关日志。要靠终端探针与网关双源发现,把本地运行态和网络侧记录对起来。
Q3:加了安全网关,会不会拖慢 Agent 的响应?
A:关键看检测放在哪一步。低风险请求直接放行,只有中高风险才进人工确认或拦截。检测环节的响应耗时 <100ms,业务链路上感知不明显。
Q4:私有化部署能不能做到数据不出内网?
A:可以。平台、终端、网关都部署在企业自有环境内,检测过程不需要把业务数据送出内网。