不少团队对翻拍识别检测的印象,是「有人拿手机对着屏幕拍」。这只是物理呈现攻击的一个子类,而三个子类的成像链路完全不同:手机对着一块播放视频的屏幕拍,是二次成像,屏幕的发光与像素结构会叠进来;设备贴到脸前直接播,屏幕几乎占满画面,画面之外的线索全没了;头像印在纸上举到摄像头前,介质换成反射式的纸;套一个立体头模,则出现三类里唯一真实的三维结构。检测难度的排序也不同——常见情形下,纸张相对容易露破绽,屏幕次之,立体面具更难;实际难度随设备、材料与拍摄条件变化。
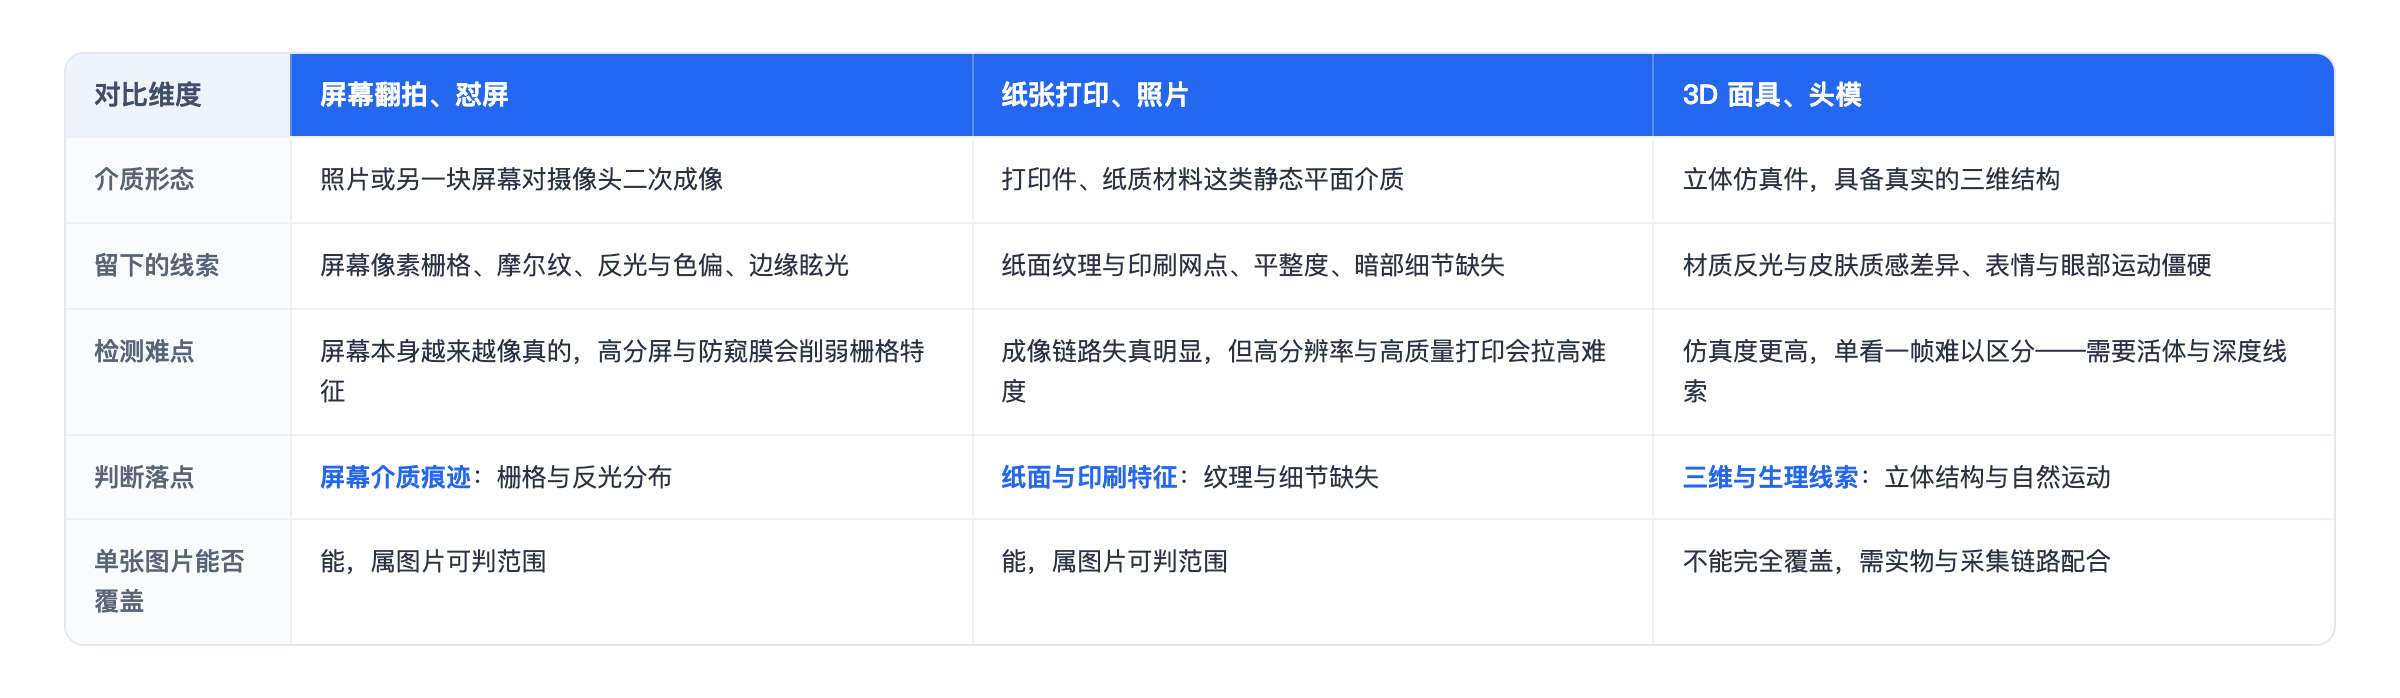
一、三类物理呈现攻击不是一道题
屏幕翻拍、纸张打印、3D 面具同属物理呈现攻击,但从介质到成像的路径完全不同,可用的证据也不同。
网易智企·易盾把物理呈现攻击与 AI 数字伪造、采集环境攻击并列为三大攻击面。物理呈现这一类里,共同点只有一个:镜头前不是活人的脸,而是某个介质承载的人脸影像。
| 攻击类型 | 介质 | 成像路径 | 差异点 | 常见检测难点 |
|---|---|---|---|---|
| 屏幕翻拍、怼屏 | 发光屏幕 | 对屏幕二次成像 | 亮度分布、表面反射、像素结构 | 有难度,屏幕素质提升会拉近差距 |
| 纸张打印、照片 | 反射式纸介质 | 平面图像直接入镜 | 纸纹网点、平面透视、光照不连续 | 较易露破绽,高精度输出会拉近差距 |
| 3D 面具、头模 | 立体仿真件 | 三维结构直接入镜 | 材质反射、微运动、边缘衔接 | 较难 |
这是常见情形下的经验排序,不能代替具体场景的测试。
易盾的静默活体(人脸欺诈检测模型)就工作在这一层:不需要眨眼、摇头,覆盖屏幕翻拍与窥屏、纸张打印与照片、3D 面具与头模三类介质;摄像头劫持与视频注入属于采集环境层,由注入攻击环境检测单独判断。
二、屏幕翻拍与怼屏:难点在「屏幕本身越来越像真的」
翻拍本该是痕迹较重的一类,但屏幕素质的提升正把痕迹压薄,依据只能从「看到屏幕」转向「判断脸成不成立」。
二次成像的痕迹是什么
翻拍是对着一块屏再拍一次。屏幕亮度动态范围比真实场景窄,亮部容易过曝、暗部细节被压平,皮肤纹理在这种压缩里会先消失;屏幕表面的玻璃或膜材会把环境光反射成位置固定、边缘锐利的亮斑,真实人脸的高光分布更散、边界更软。这些特征都是相对的:屏幕素质与拍摄条件一旦提上去,就缩到接近噪声。
高端屏与防窥膜带来的干扰
高分辨率屏把像素结构做得越来越细,算法能用的栅格类线索变弱;广色域与高亮度又让屏幕上的肤色更接近真实分布。防窥膜的干扰走另一条路:收窄可视角度、压低正面亮度,画面整体偏暗,依赖亮度异常的判断失去参照。怼屏把干扰推到极致——屏幕几乎贴到脸上,边框、持机手指这些画面外的线索全被裁掉。
检测要看什么
痕迹被压薄后,依据只能回到人脸本身。易盾的思路是先学习大量真实人脸,理解面部结构与光影一致性,再定位不符合真实生成规律的地方——不是找屏幕的破绽,而是判断这张脸作为三维物体是否成立。静默活体补的是三维深度与生理运动特征:屏幕是平面,真人转头时的视差它给不出来(这类信号依赖采集方式,例如活体采集过程,单张静态图片提供不了)。
三、纸张打印与照片:成像链路失真较为明显,但分辨率与打印质量会拉高难度
纸是反射介质、画面是平的,这两点让它在三类里更容易露出破绽,但打印精度与拍摄光照会把差距拉近。
纸纹与网点
纸张有纤维结构,打印靠墨滴或碳粉堆叠成图,放大后是规则排列的网点。这层结构覆在皮肤纹理之上,把连续的肤色过渡切成离散的点;纸面轻微卷曲也会带来不符合人脸曲率的光照不均。两条线索都受输出质量制约:输出足够精细时,网点会细到接近连续调。
二次拍摄的光照不一致
纸面平整,反光集中、缺少曲面上的连续光照梯度;真实人脸是曲面,从额头到下颌有一条连续光照梯度,高光位置由骨骼决定。纸面上的「脸」没有这些结构,纸面的光影变化难以与真实人脸曲面一致。真人的光影自洽,纸面的光影是外部打上去的——光影不自洽,是这一类较稳的证据。
边界情况
另外,静态内容表现在屏幕上(「屏中图」)会让两类的特征边界变模糊;输出质量与拍摄光照一旦提上去,纸面也能做得接近屏幕。所以检测不能按介质类型分级,只能按画面证据判断。
四、3D 面具与头模:三类里仿真度更高的一类
3D 面具是三类里唯一拥有真实三维结构的介质,几何、阴影、遮挡都能对上,平面痕迹的思路在这里失效。
材质与微运动
立体结构的优势是真的:鼻梁会投影在面颊上,转头有正确的视差与自遮挡。翻拍和打印靠「平面」暴露自己,面具不靠这个。它暴露在材质上——人皮肤半透,光进入浅层散射后再出射,肤色有通透感;硅胶、树脂类材料更接近均匀反射。眼睛更难:瞳孔收缩、眼白湿润反光、眼周肌肉联动很难同时成立。
为什么需要无感活体参与判断
对 3D 面具做交互式校验,代价有两个:要求眨眼、摇头、张嘴会抬高正常用户的通过成本;动作指令若固定不变,攻击方就有时间做针对性准备——易盾的交互式活体会把指令序列实时动态打乱。静默活体不要求配合,直接从三维深度与生理运动特征判断真伪。
五、检测思路上,物理攻击和 AI 伪造要分开打
物理攻击的证据留在成像链路上,生成式伪造的证据留在生成过程里,注入攻击的证据不在画面里。
易盾把鉴伪拆成四个模型:Deepfake 伪造检测模型负责 AI 换脸与生成式人脸;AI 水印识别模型识别生成图像的水印特征,作辅助信号交叉验证;人脸欺诈检测模型即静默活体,负责屏幕翻拍、窥屏、纸张打印、3D 面具;人脸注入攻击环境检测负责摄像头劫持与视频注入。四路判断汇总到同一风险判定环节,输出通过、拦截、风险提示三种结果。这套三态结论属于方案层;单张图片的检测只给出「正常」或「伪造」。
理由不是工程偏好,是证据形态不同。物理攻击的破绽在「画面怎么被拍下来」,属于成像链路;生成式伪造的破绽在「这张脸怎么被生成」,属于生成过程,与介质无关;注入攻击的破绽不在画面里,异常出在采集环境。
传统活体主要针对照片、屏幕、面具,面对 AI 换脸、视频注入存在盲区。三类证据分开取再联合研判,翻拍识别检测才不至于被更强的伪造手法整体绕开。
常见问题
Q1:翻拍识别检测和活体检测是一回事吗?
A:不是。活体检测回答「镜头前是不是活人」,翻拍识别检测回答「这张脸是不是某个介质承载的影像」。静默活体覆盖物理呈现攻击,与交互式活体并行。
Q2:三类里哪一类的检测难度更高?
A:常见情形下,纸张打印相对容易露破绽;屏幕翻拍次之,屏幕素质还在提升;3D 面具更难,它有真实三维结构,平面痕迹的思路用不上。实际难度仍要看设备、材料与样本条件。
Q3:屏幕上放一张静态照片,算翻拍还是算打印?
A:从介质看是屏幕翻拍的一种变形:发光屏、二次成像,内容为静态图。分类的意义在选检测路径,不在给攻击起名字。
Q4:只报一个总识别率够不够?
A:不够。三类样本难度不同,混算总数,高难度样本的短板会被低难度样本盖住。至少按介质分组报,并写清样本条件与指标全名。
想先看一张图片的鉴伪结果,可以在线体验:人脸鉴伪在线体验;分介质的检出效果需要在接入场景里用真实样本验收。