注册、登录、领权益、办业务,越来越多的环节要求用户把脸对准摄像头。产品团队的两难在于:要确认镜头前是活人,常见做法是让用户「眨眨眼」「摇摇头」「张张嘴」——动作一多,流程繁琐,弱光下做不对、戴眼镜反光,真人也会被拦下;动作太简单,又怕一段录好的素材就能混过去。
静默活体要解的就是这个矛盾:不做指定动作,也要判断镜头前是不是真人。本文拆四件事——它在判断什么、靠什么信号、能覆盖哪些介质、与交互式活体怎么分工,最后讲清边界:哪些情况下它给不出结论。
一、静默活体在判断什么
静默活体判断的是「镜头前这张脸是否来自真实活人」,不要求用户配合做指定动作,依据是采集过程中自然留下的信息。
「静默」说的是交互方式,不是检测强度,也不限定输入形态:用户正常看着镜头,不点头、不张嘴、不念数字,具体用单帧画面、连续画面还是其他采集信息,取决于方案实现。
它不回答另外三个问题:这个人是不是他说的那个人,归人脸比对与实人认证;这张脸有没有被生成或换过,归 Deepfake 检测与 AI 水印识别;画面是不是来自这个镜头,归注入攻击环境检测。
在网易智企·易盾的人脸核验能力里,静默活体对应人脸欺诈检测模型这一路,与另外几路检测并行,各自给出判断,再汇总研判。
二、静默活体靠什么信号判断真人
它主要看两类信号——人脸作为三维物体的深度关系,以及活人身上自然发生的生理运动。
三维深度:平面给不出的那部分
人脸不是一张画。鼻梁会挡住一侧脸颊,眼窝低于颧骨,转头时近处与远处的位移幅度不同,这些关系构成深度线索。屏幕和纸都是平面:打印照片可以很清晰,却没有与面部曲率一致的起伏;屏幕能播放转头的画面,但里面的视差是拍摄时录下的,不是眼前这个物体自己产生的。
深度信号拿不拿得到,取决于采集条件。带深度摄像头的设备能直接拿到面部起伏;只有普通彩色画面时,可用线索更少,判断更多依赖遮挡、光照与画面变化这类间接信息。同一套判断逻辑在不同设备上表现有差别,原因多半在这里。
生理运动:不要求,但会发生
一个人被要求「保持不动」,身体仍在动:呼吸、眨眼、头颈的轻微位移,都不需要配合就会发生。但这些线索不是真人独有——照片可以被拿着移动,回放的视频里也带着真实的眨眼与呼吸。判断要综合介质的成像、材质、空间结构以及可用的时序线索,出现自然动作并不足以单独证明是真人现场采集。
这里有个容易混淆的点:「静默」不等于「完全不看动作」。它看的是自然发生的动作,不是被指令要求的动作。要求用户摇头,是把动作当成答题;静默活体把动作当成证据。
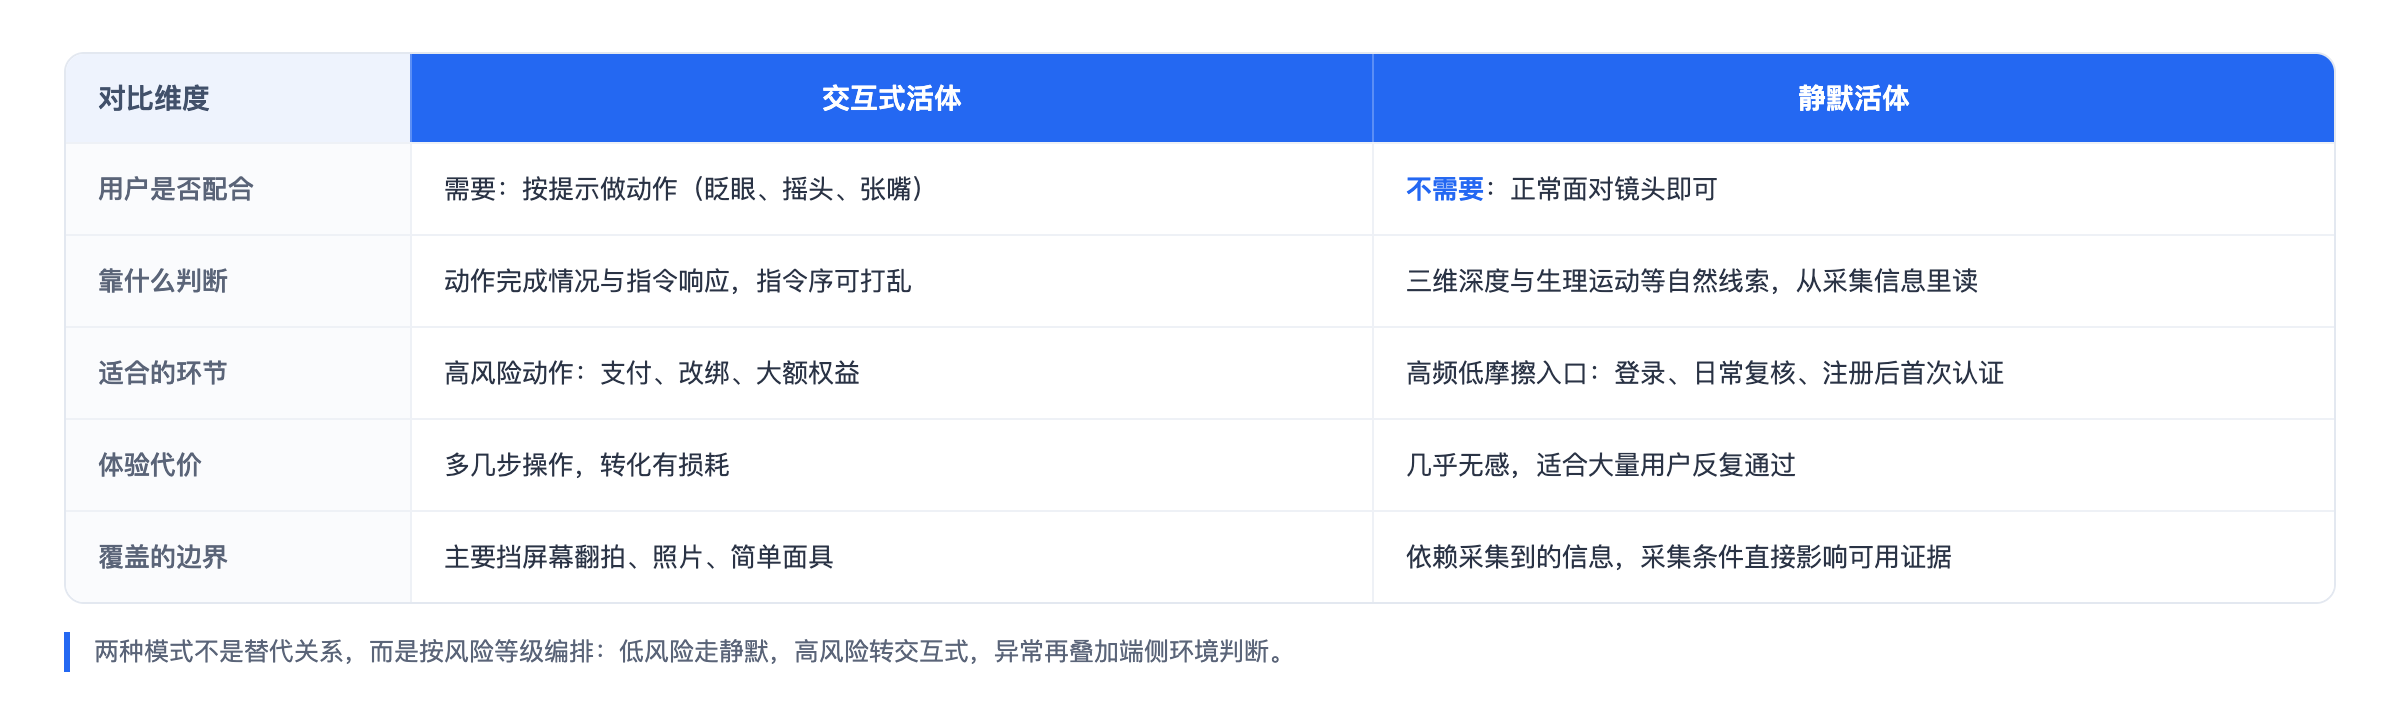
图注:交互式与静默不是替代关系:低风险走静默,高风险转交互式,异常再叠加端侧环境判断。
三、静默活体能覆盖哪几类物理介质
覆盖范围是物理呈现攻击里的三类介质——屏幕翻拍与窥屏、纸张打印与照片、3D 面具与头模。
三类介质的共同点,是镜头前不是活人的脸,而是承载人脸影像的物件;区别在于各自留下什么异常线索。
| 介质 | 可观察的异常线索 | 判断落点 |
|---|---|---|
| 屏幕翻拍、窥屏 | 深度与光照梯度偏平面,常见重拍形成的纹理与反光 | 平面二次成像,深度线索不足 |
| 纸张打印、照片 | 平面透视与光影关系不自洽 | 平面成像痕迹明显 |
| 3D 面具、头模 | 皮肤质感、眼周联动偏生硬 | 材质与微运动线索不足 |
常见情形下,纸张相对容易露破绽,屏幕次之——屏幕素质在提升,平面痕迹被压薄;3D 面具较难,它自带立体结构,几何与遮挡能对上。实际难度随设备、材料与样本条件变化,不能只按介质类型下判断。
这个范围之外还有一类:摄像头劫持、虚拟摄像头、视频注入。它们的问题不是「镜头前放了什么」,而是「画面是不是来自这个镜头」,属于采集环境侧,由注入攻击环境检测负责判断。易盾的静默活体对劫持画面常见的运动模糊、黑边做过专项优化,但劫持与否的结论不由它给出。
四、静默活体与交互式活体怎么取舍
不是谁更强,而是按环节风险选——高风险环节要交互式的对抗强度,高频日常环节要静默的通过体验。
| 对比维度 | 交互式活体 | 静默活体 |
|---|---|---|
| 用户动作 | 按提示眨眼、摇头、张嘴 | 无需指定动作 |
| 对抗重点 | 指令序列实时动态打乱,预制素材对不上号 | 介质在成像、材质与自然运动上留下的线索 |
| 体验成本 | 有通过成本,弱光、戴镜时容易失败 | 无感,适合高频环节 |
| 适用环节 | 开户、账号找回、高价值权益 | 登录、日常核验、内容发布 |
交互式的优势是「不确定」:用户事先不知道会被要求做什么,预先录好的固定动作素材对不上号,绕过难度明显上升。代价落在正常用户身上——动作做不对、光线不够、镜片反光,都会让真人多试几次。
静默的优势是「不打扰」,代价是判断更多落在细微线索上,光线、压缩与抖动会直接影响可用证据。取舍该按环节:一次核验背后如果连着资金、身份或高价值权益,多一步配合值得;每天大量重复的登录校验,把动作成本摊给每个用户,流失会先出现。检测方式因此按风险等级编排:低风险环节走静默,高风险环节叠加交互式,出现风险提示时再升级校验。两种模式都能与人脸比对联动,一次完成「是否活人、是否本人」两件事。
五、静默活体的边界在哪
静默活体需要的是采集环节留下的信息,可用证据的量由采集方式决定。
第一条边界在可用信息。单帧画面没有时序,能读到的线索天然更少;用单帧还是连续画面取决于方案实现,但判断都落在采集环节——把一张截图单独送进图片鉴伪,回答的是「这张脸是否被生成、换脸、翻拍」,那是另一层的工作。
第二条边界在采集方式。深度信号有没有、连续画面够不够、压缩损失大不大、光线稳不稳定,都会改变可用证据的量。同一副面具,光线均匀、画面清晰时容易露破绽;逆光、抖动、严重压缩的画面里,证据被噪声吃掉,判断只能更保守。
第三条边界在覆盖范围。它主要识别物理呈现攻击,不负责生成式伪造;对劫持画面常见的运动模糊、黑边做过专项优化,但采集链路是否可信,仍要由端侧环境检测判断。
还有一层常被混淆:模型的输出与方案的输出不是一回事。人脸深伪检测对单份素材给出「正常」或「伪造」加风险类型,活体检测给出这一关是否通过;把端侧环境、活体与风控汇总之后,才会有通过、拦截、风险提示这组三态结论——三态属于方案层,不是上传一张图就能拿到的结果。
常见问题
Q1:静默活体要求用户完全不动吗?
A:不要求指定动作,也不要求「一动不动」。用户正常看着镜头即可;眨眼、呼吸这类自然发生的动作,会作为判断线索之一。
Q2:静默活体和交互式活体,哪个更难被绕过?
A:看攻击方式。交互式强在防预制素材,指令随机、序列实时打乱,事先录好的动作对不上;静默的强项在于介质在成像、材质与自然运动上留下的线索,但它更依赖细微信息,采集条件的影响更直接。高风险环节优先交互式,日常高频环节用静默更合适。
Q3:普通手机前置摄像头没有深度传感器,还能用吗?
A:能,但要看采集条件。没有直接深度信息时,可用线索更少,判断更多依赖遮挡、光照与画面变化这类间接信息,光线稳定、画面清晰、采集过程完整时更可靠;证据不足时结论会更保守,必要时升级为交互式校验。
Q4:静默活体能识别 AI 换脸吗?
A:不归它管。AI 换脸、生成式人脸属于数字伪造,由 Deepfake 检测模型与 AI 水印识别处理;静默活体只回答「镜头前是不是活人」,两路判断在方案里汇总后再定处置。
六、想先看一份素材的判定结果
与其看描述,不如拿自己的素材跑一遍。
易盾 DeepGuard 人脸鉴伪提供在线体验,上传一张人脸图片就能看到「正常」或「伪造」的结论与风险类型,可先用脱敏样本试一轮。静默活体这一层的完整效果,需要在接入场景的活体采集环节用真实样本验收。易盾的 DeepGuard 人脸鉴伪在中国信通院「可信 AI」人脸鉴伪专项评测中获卓越级,并在网易云音乐、网易游戏、LOFTER、网易邮箱等业务完成日均百万级检测验证。